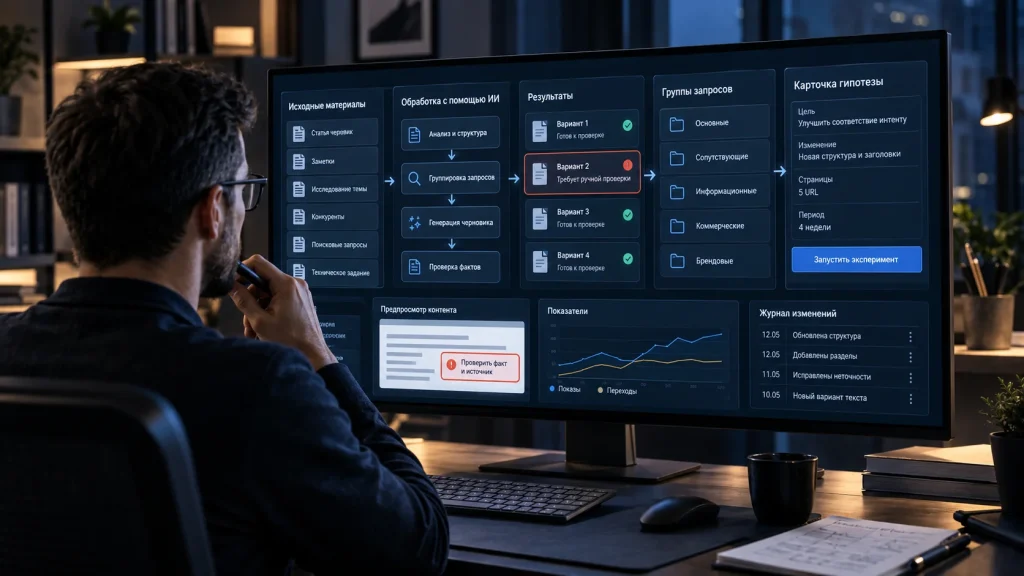
Редактор загружает в нейросеть подборку заметок, получает складный черновик и уже через минуту замечает, что убедительная фраза опирается на несуществующую цифру. Поэтому разговор об искусственном интеллекте неизбежно касается редакционного контроля, структуры данных и методики поисковых наблюдений.
Какие задачи искусственный интеллект выполняет без лишнего риска
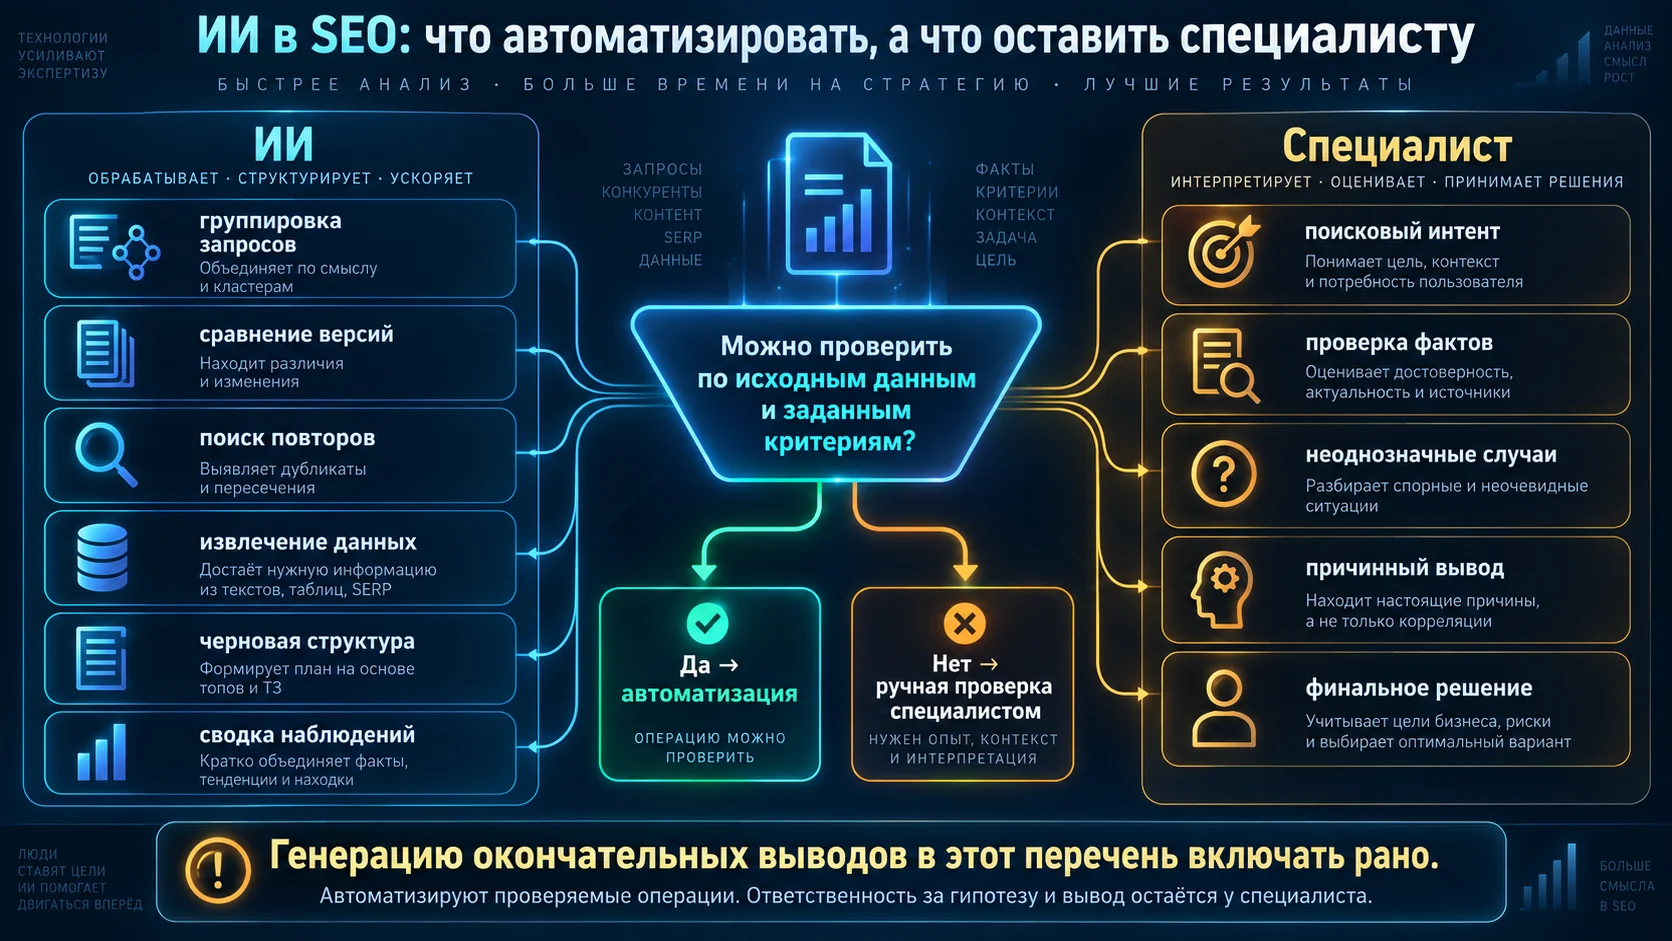
Искусственный интеллект разумно применять там, где результат можно быстро проверить по понятному образцу. Он группирует запросы, сокращает длинные документы, сравнивает версии текста, предлагает структуру инструкции и находит повторяющиеся формулировки. Редактор видит исходные данные и способен установить, пропущен ли существенный факт. Если ошибка обнаруживается только через месяц или требует узкой экспертизы, полную автоматизацию лучше отложить.
Граница проходит не между творческой и механической работой. Составление таблицы иногда требует больше содержательных решений, чем первый черновик статьи. Значение имеют цена ошибки и возможность обратной проверки. Нейросеть может разнести сотни запросов по предполагаемым намерениям читателя, однако специалисту всё равно придётся открыть спорные группы: одинаковые слова нередко скрывают разные задачи, а близкие формулировки ведут к материалам разных типов.
Особенно заметна польза при работе с большим массивом однотипных документов. Система извлекает названия, даты, ограничения и единицы измерения, после чего человек сверяет результат с оригиналом. Здесь машина действует как быстрый сортировщик. Но если исходный документ отсканирован плохо, число с размытой запятой может изменить смысл всей строки. На экране такая ошибка почти не шумит: таблица выглядит чистой, ячейки стоят ровно.
Автоматическое резюме тоже требует заранее заданного назначения. Для редактора существенны источники и оговорки, для технического специалиста — последовательность действий, для владельца проекта — ограничения и ожидаемый объём работ. Просьба «кратко пересказать документ» не сообщает системе, что нельзя потерять. Гораздо точнее перечислить обязательные элементы ответа и отдельно запретить домыслы.
Задачи с предсказуемой проверкой:
- выделение повторов, канцелярских оборотов и слишком длинных предложений;
- сопоставление двух редакций документа с указанием изменённых фрагментов;
- распределение материалов по заранее описанным рубрикам;
- подготовка вопросов к тексту, на которые читатель пока не получает ответа;
- приведение разрозненных записей к единому формату без изменения фактов;
- поиск пустых полей, нарушенной нумерации и несогласованных единиц измерения.
Генерацию окончательных выводов в этот перечень включать рано. Модель строит ответ по вероятностным связям и может уверенно заполнить пробел правдоподобной деталью. На деле опаснее всего не грубая нелепость, а аккуратная неточность: неверная дата, приписанное документу требование или причина, которой в исходных материалах не было.
Как устроить автоматизацию, которую можно проверить
Надёжная автоматизация начинается с наблюдаемой цепочки действий. В ней известны источник данных, правило обработки, формат результата и человек, принимающий спорное решение. Если система просто получает папку документов и выдаёт готовую публикацию, ошибка растворяется между этапами. Когда каждый промежуточный файл сохраняется, редактор находит место сбоя без повторной проверки всего массива.
Рабочая схема часто выглядит скромнее рекламных демонстраций. Сначала программа принимает материал только из разрешённых источников. Затем извлекает нужные поля и помечает фрагменты, которые не удалось распознать однозначно. Нейросеть готовит черновик по утверждённому плану, но рядом остаются ссылки на исходные отрывки внутри редакционной системы. Человек проверяет утверждения, после чего запускаются обычные проверки орфографии, структуры и разметки.
Поисковая оптимизация (SEO), в том числе эксперимент топовысок в seo, ставит перед автоматизацией похожую задачу: ускорить рутинную работу, но не принять гладкий текст за достоверный результат. В обеих сферах полезен один принцип: машине передают повторяемые операции, а человеку оставляют постановку задачи, проверку фактов и разбор неоднозначных сигналов.
Полезно разделять инструкцию для модели и фактическую основу. В первой находятся требования к стилю, длине, структуре и запрещённым формулировкам. Во второй — документы, наблюдения, числа и названия, которые разрешено использовать. Тогда обновление сведений не требует переписывать всю инструкцию, а изменение редакционного тона не затрагивает исходные факты.
Вечером перед выпуском особенно хорошо видна цена непрозрачной схемы. В комнате слышен ровный гул системного блока, редактор меняет одно предложение, а автоматический сценарий внезапно перезаписывает уже проверенный абзац старой версией. Причина обычно прозаична: этапы используют файлы с одинаковыми именами или не фиксируют номер редакции. Сохранение промежуточных версий кажется избыточным лишь до первого такого случая.
Контрольные точки редакционного сценария:
- зафиксировать, откуда поступают сведения и кто обновляет исходные документы;
- отделить подтверждённые данные от предположений и редакционных комментариев;
- задать формат ответа, включая поля для неопределённости и отсутствующих сведений;
- сохранять исходный текст, машинный черновик и проверенную редакцию раздельно;
- назначить ручную проверку утверждений, способных повлиять на деньги, здоровье, безопасность или юридические действия;
- записывать причину исправления, если одна и та же ошибка повторяется.
Журнал исправлений нужен не для отчётности. Через несколько недель он показывает, где система стабильно ошибается: смешивает характеристики похожих услуг, теряет отрицание, неверно понимает сокращение или дополняет пустое поле. После этого меняют конкретное правило, а не всю схему. Иногда достаточно запретить модели заполнять пропуски и потребовать явную пометку «сведений нет».
Не все операции стоит соединять в один длинный сценарий. Отдельный запуск для извлечения фактов, отдельный для построения плана и ещё один для языковой правки легче проверять, чем единый запрос с десятками условий. Правда, дробление имеет предел: если сотруднику приходится вручную переносить результат между множеством окон, автоматизация начинает отнимать время. Тут считают реальные действия, а не число подключённых инструментов.
Поисковый эксперимент начинается не с генерации статей
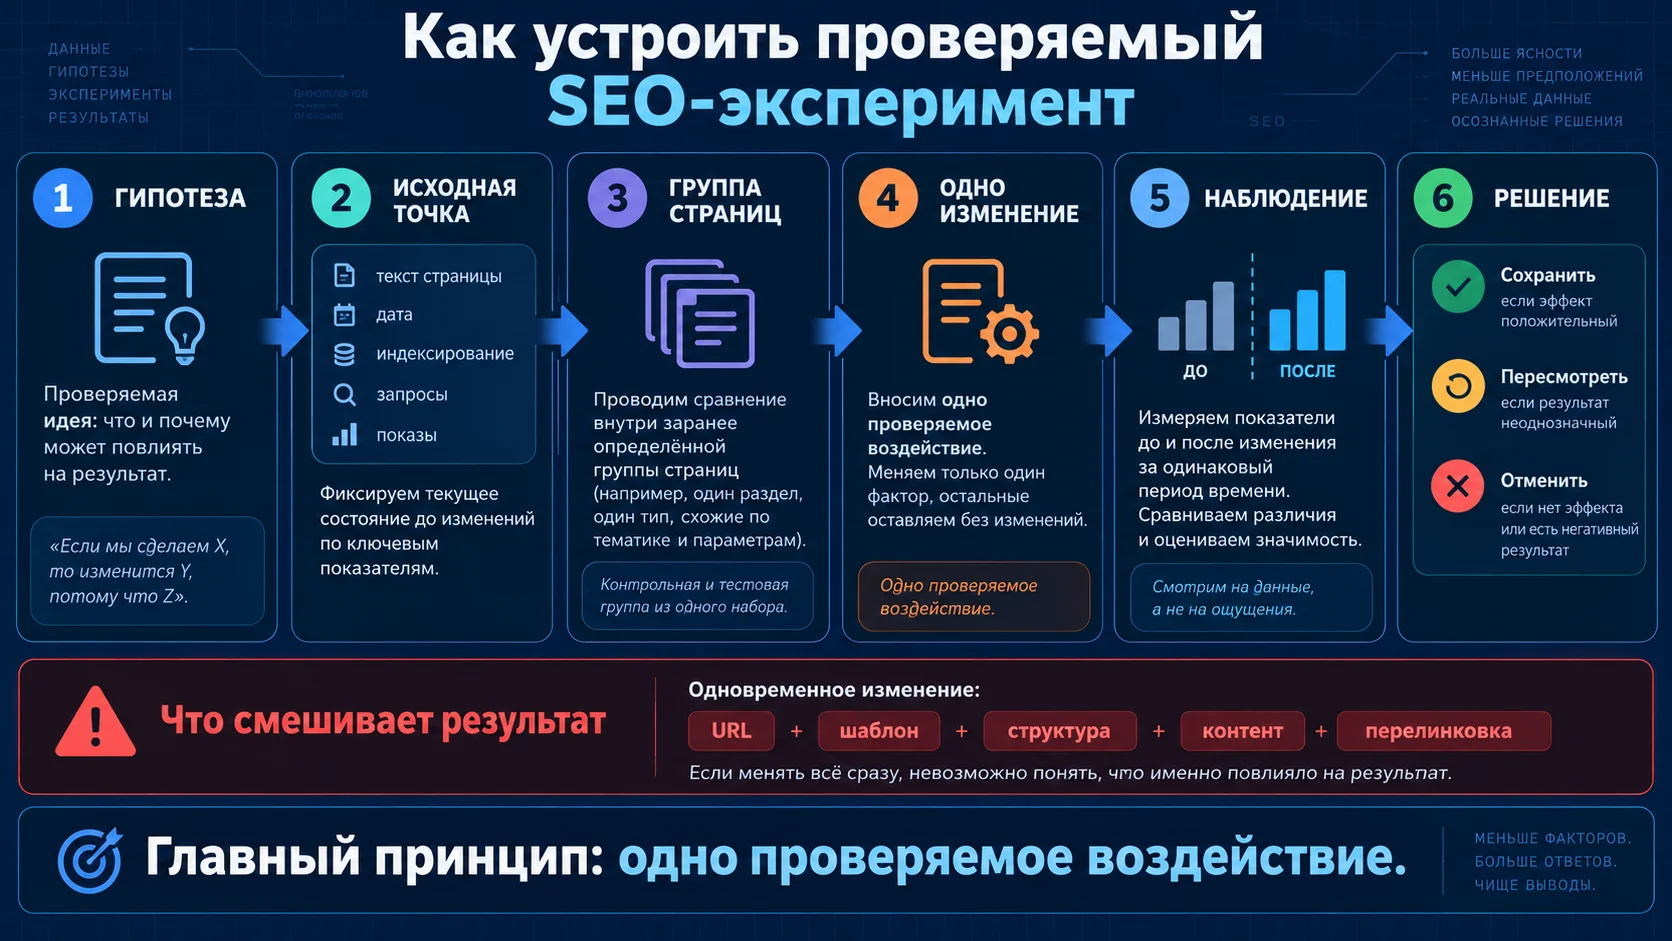
Поисковый эксперимент следует начинать с проверяемой гипотезы, исходного состояния и заранее выбранных признаков успеха. Формулировка «улучшить позиции» слишком расплывчата: она не объясняет, какие страницы меняются, по каким запросам наблюдается результат и за какой период сравниваются данные. Без этих границ любое колебание легко объявить подтверждением.
Искусственный интеллект ускоряет подготовительную работу. Он собирает близкие формулировки в смысловые группы, сравнивает заголовки страниц, отмечает неполные ответы и помогает превратить редакционные заметки в перечень гипотез. Но решение о том, что именно проверяется, принимает специалист. Иначе инструмент одновременно изменит структуру, объём, заголовок и внутренние переходы, после чего определить причину результата уже не получится.
Есть и другая ловушка: массовое производство текстов создаёт ощущение большого эксперимента, хотя методически это множество несопоставимых изменений. Одни страницы получают новые разделы, другие меняют назначение, третьи начинают отвечать на соседний запрос. Объём работы растёт, а знание о причинной связи остаётся прежним. Лучше выбрать ограниченную группу сходных материалов и менять один существенный элемент либо заранее описанный набор связанных элементов.
Исходное состояние фиксируют до публикации. Сохраняют текст страницы, дату изменения, сведения об индексации, запросы, по которым уже были показы, и технические параметры, способные исказить наблюдение. Если одновременно меняются адреса, шаблон сайта и правила формирования заголовков, редакционный опыт смешивается с технической перестройкой.
Что отделяет наблюдение от случайного изменения:
| Часть опыта | Что фиксируют | Чем грозит пропуск |
|---|---|---|
| Гипотеза | Ожидаемое изменение и предполагаемая причина | Любой результат можно истолковать задним числом |
| Исходная точка | Состояние страницы и доступные поисковые показатели | Нечего сравнивать после обновления |
| Группа материалов | Сходство назначения, структуры и уровня спроса | Различия страниц принимают за действие правки |
| Редакционное изменение | Конкретные фрагменты и дата публикации | Причина результата остаётся неизвестной |
| Внешние события | Технические сбои, сезонные колебания, крупные обновления сайта | Посторонний фактор приписывают содержанию |
| Условие остановки | Срок пересмотра и признаки бесполезного опыта | Наблюдение продолжается без решения |
Нейросеть способна поддерживать такой журнал: сводить записи, находить незаполненные поля, напоминать о несовместимых изменениях. Ей нельзя поручать окончательную оценку причин только по соседству дат. Если показатель вырос после редакционной правки, это ещё не доказывает, что рост вызвала именно она. Могли измениться спрос, состав выдачи, техническое состояние сайта или поведение конкурирующих материалов.
Редакционный опыт здесь неожиданно полезен. Специалист, привыкший сверять машинный черновик с источником, так же осторожно сопоставляет поисковую гипотезу с журналом изменений. Он не принимает красивую последовательность событий за доказательство и замечает пропуски, которые автоматическая сводка сгладила бы.
Почему контроль фактов важнее скорости публикации
Контроль фактов нужен не после генерации, а на каждом этапе, где система преобразует исходные сведения. Ошибка может появиться при распознавании файла, сокращении документа, объединении записей или литературной правке. Финальная вычитка поймает заметное противоречие, но едва ли восстановит потерянное ограничение, если редактор уже не видит первоисточник.
Удобнее проверять утверждения по уровню риска. Нейтральное описание интерфейса можно сверить быстрым просмотром. Число, срок, техническое ограничение либо рекомендацию с возможными материальными последствиями проверяют непосредственно по документу. Ссылку на источник внутри рабочей системы сохраняют рядом с утверждением, а не в общей папке, где спустя неделю лежат десятки похожих файлов.
Автоматическая проверка не заменяет такую сверку, но хорошо отсеивает формальные несоответствия. Программа находит разные написания одного термина, даты вне заданного периода, единицы измерения без величины, утверждения без пометки источника. Она может сравнить готовый материал с перечнем разрешённых фактов и выделить новые числа. Красная отметка в поле не доказывает ошибку; она просит человека остановиться.
Наиболее коварна правка ради гладкости. Нейросеть убирает повтор и заодно меняет степень уверенности: «может вызвать» становится «вызывает», «в отдельных случаях» исчезает, приблизительное значение выглядит точным. Фраза звучит сильнее, однако документ говорил осторожнее. Поэтому перед публикацией сравнивают не только факты, но и модальность утверждений, особенно отрицания, исключения и условия.
Редко кто замечает эту потерю при чтении одного готового абзаца. Разница проявляется в парном просмотре: слева лежит исходный фрагмент с сухой оговоркой, справа — лёгкая уверенная проза. Такая уверенность настораживает. Если система не умеет сохранять границы знания, её вывод используют как заготовку, а не как готовый редакционный материал.
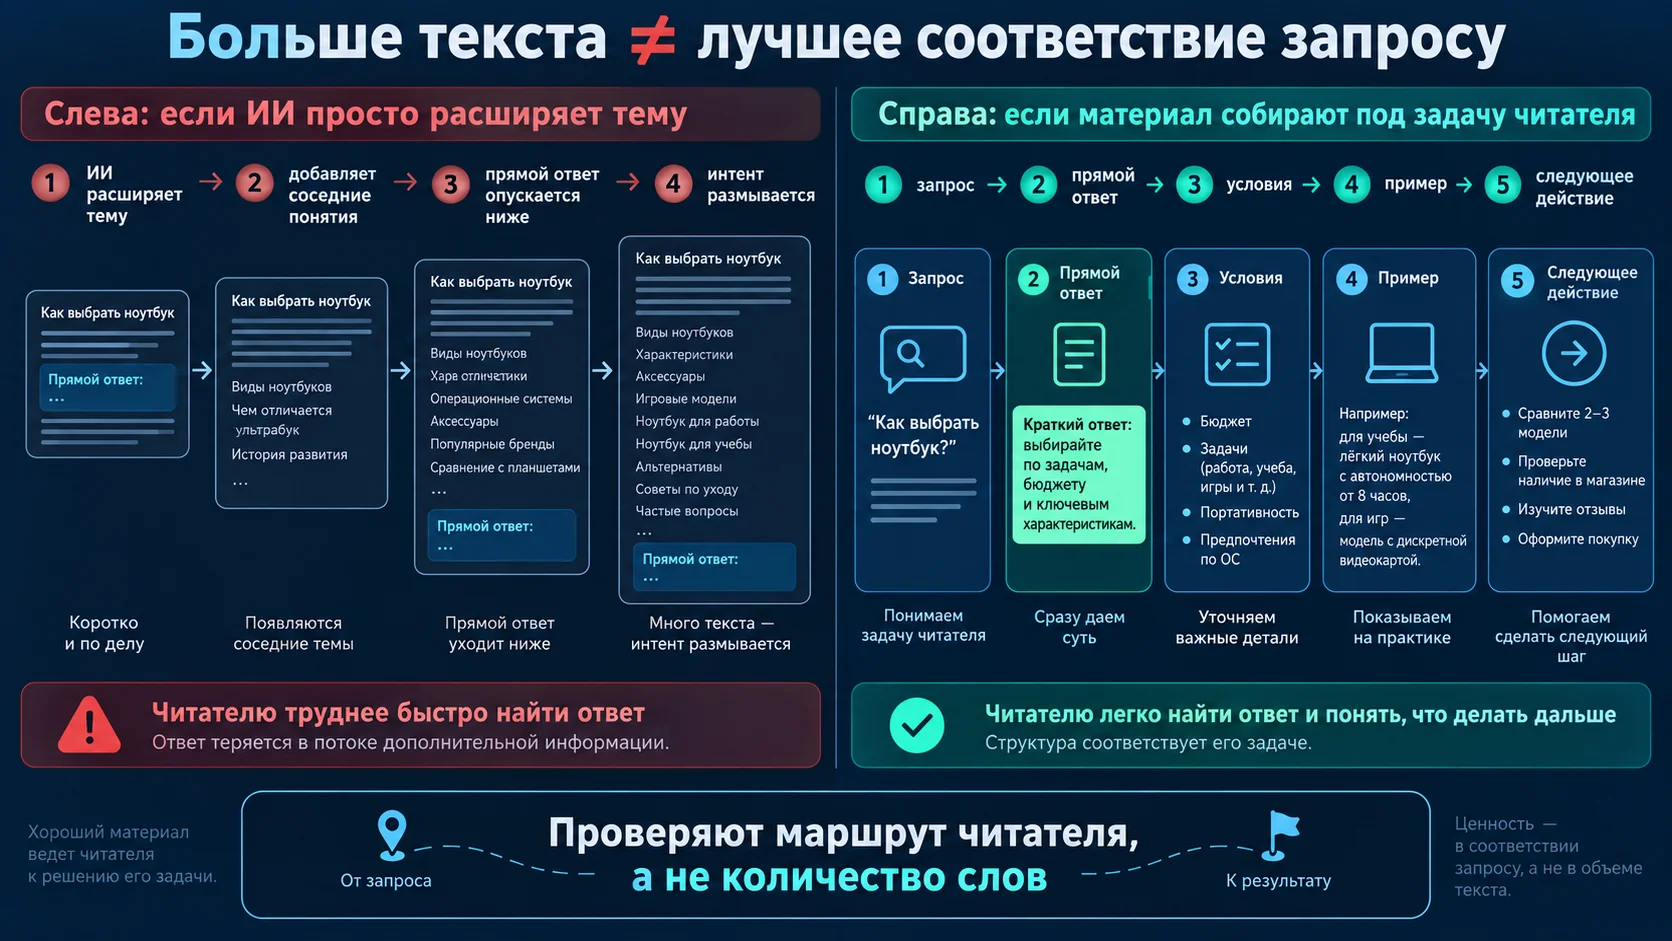
Для поисковой работы искажение не менее опасно. Страница может получить больше связного текста, но хуже отвечать на исходную потребность читателя. Машина расширяет тему по лексической близости, добавляет соседние понятия и разбавляет прямой ответ. В результате материал становится длиннее, а основная задача прячется ниже. Проверяют не число слов, а маршрут читателя: насколько быстро он находит ответ и понимает, на каких условиях тот действует.
Слабые фрагменты не всегда нужно наращивать. Иногда абзац следует сократить до двух предложений, убрать повтор заголовка или вынести исключение ближе к правилу. Автоматизация полезна, когда предлагает несколько редакций и объясняет различия. Выбор остаётся за редактором, ведь именно он видит весь документ, а не только локальный отрывок.
Какие показатели объясняют результат поискового опыта
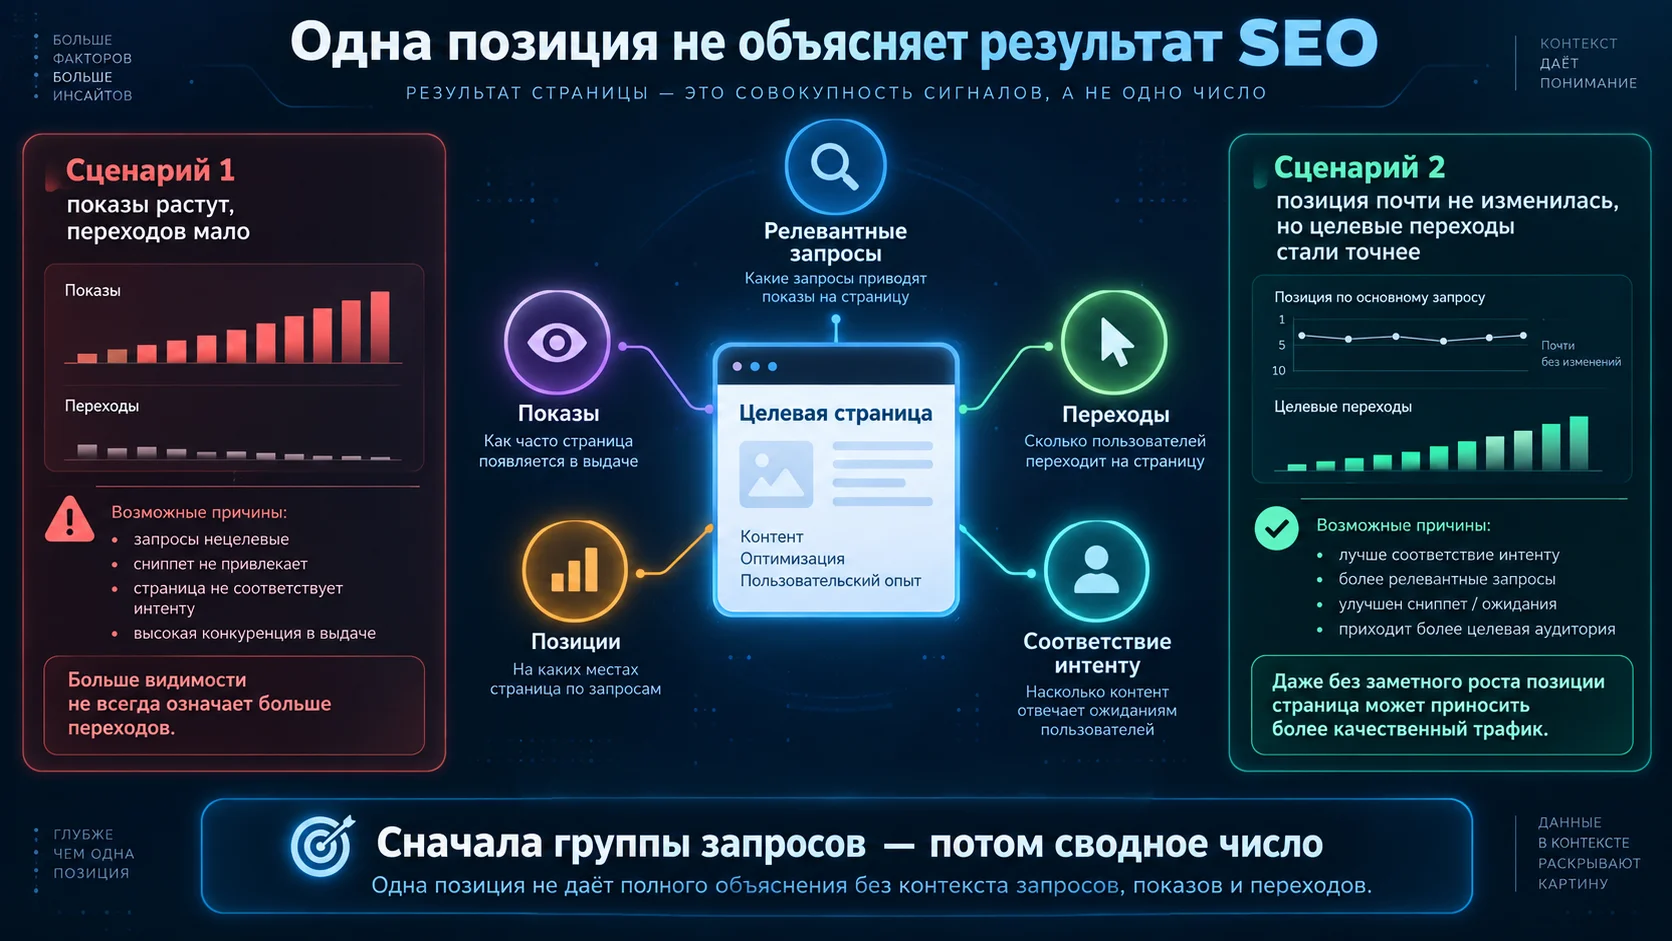
Результат поискового опыта нельзя оценивать по одной позиции или одному короткому отрезку наблюдений. Смотрят на совокупность признаков: появилась ли страница в поиске, расширился ли набор релевантных запросов, изменились ли показы и переходы, сохранилось ли соответствие содержания намерению читателя. Каждый показатель отвечает на свой узкий вопрос и не заменяет остальные.
Средняя позиция способна меняться из-за состава запросов. Если страница начала показываться по новым, более широким формулировкам, общее значение иногда ухудшается, хотя видимость стала шире. Рост показов без переходов тоже неоднозначен: заголовок может не обещать нужного ответа, а сама страница может появляться по запросам, которым соответствует лишь частично. Сначала разбирают группы запросов, затем сводное число.
Поисковые данные приходят с задержками и ограничениями, поэтому мгновенный вывод после публикации ненадёжен. В первые дни страницу могут переобходить, заново сопоставлять с запросами и показывать нестабильно. Фиксированный срок наблюдения выбирают с учётом размера сайта, частоты обхода и характера спроса, но не придумывают универсальное количество дней. Для одной страницы достаточно увидеть направление, для другой приходится ждать повторяемой картины.
Искусственный интеллект здесь работает как аналитический помощник. Он сравнивает периоды, группирует запросы по смыслу, выделяет страницы с необычной динамикой и готовит вопросы для ручного разбора. Впрочем, модели нужен строгий формат входных данных. Смешение процентов и абсолютных значений, разных периодов либо страниц с несопоставимым назначением рождает убедительное, но пустое объяснение.
Полезна проверка на альтернативную причину. Перед тем как связать рост с текстовой правкой, специалист просматривает технические изменения, сезонность, появление новых страниц и перераспределение внутренних переходов. Затем изучает сам поисковый спрос: изменились ли формулировки, по которым находят материал. Если картина расходится с гипотезой, опыт не объявляют неудачным автоматически. Он мог показать иной механизм.
Например, новый раздел не улучшил видимость основной страницы, но начал привлекать запросы с другим намерением. Тогда у редактора два пути: убрать ответ как отвлекающий или выделить для него самостоятельный материал. Машина заметит новую группу формулировок; смысловое решение потребует понимания структуры сайта и читательского маршрута.
Неудачный опыт тоже сохраняют в журнале. В нём ценны границы применимости: какое изменение не сработало, при каких исходных условиях и какие посторонние события мешали оценке. Без такой записи команда через несколько месяцев повторит ту же правку под другим названием. Бумага или экран здесь не важны; важна возможность восстановить ход решения, включая сомнение, возникшее в середине наблюдения.
Автоматизация остаётся инструментом редактора
Искусственный интеллект освобождает редактора от сортировки, первичного сравнения и повторяющихся проверок, но не снимает ответственности за смысл. Чем быстрее система выпускает черновики, тем яснее должны быть границы разрешённых данных и точки ручной остановки. Иначе скорость лишь увеличивает число материалов, в которых одна незаметная неточность повторяется десятки раз.
Поисковый эксперимент добавляет к этой работе дисциплину наблюдения. Он заставляет сохранять исходное состояние, разделять правки и терпеть неопределённость там, где данных пока мало. Редактор возвращается к тексту не ради механического наращивания объёма, а чтобы проверить ответ, источник и путь читателя. Иногда следующим действием становится новая публикация. Иногда — короткая пометка в журнале и отказ менять страницу до следующего замера.